Novo chip de IA da Nvidia estreia no principal teste de treinamento com até o dobro da velocidade por GPU; TPU do Google chega perto
Na rodada MLPerf Training v6.1, o Vera Rubin NVL72 foi o mais rápido em seis de sete testes, segundo a Nvidia. TPU Ironwood do Google estreou perto do GB300 em 8.192 chips; AMD ficou fora dos testes mais pesados.
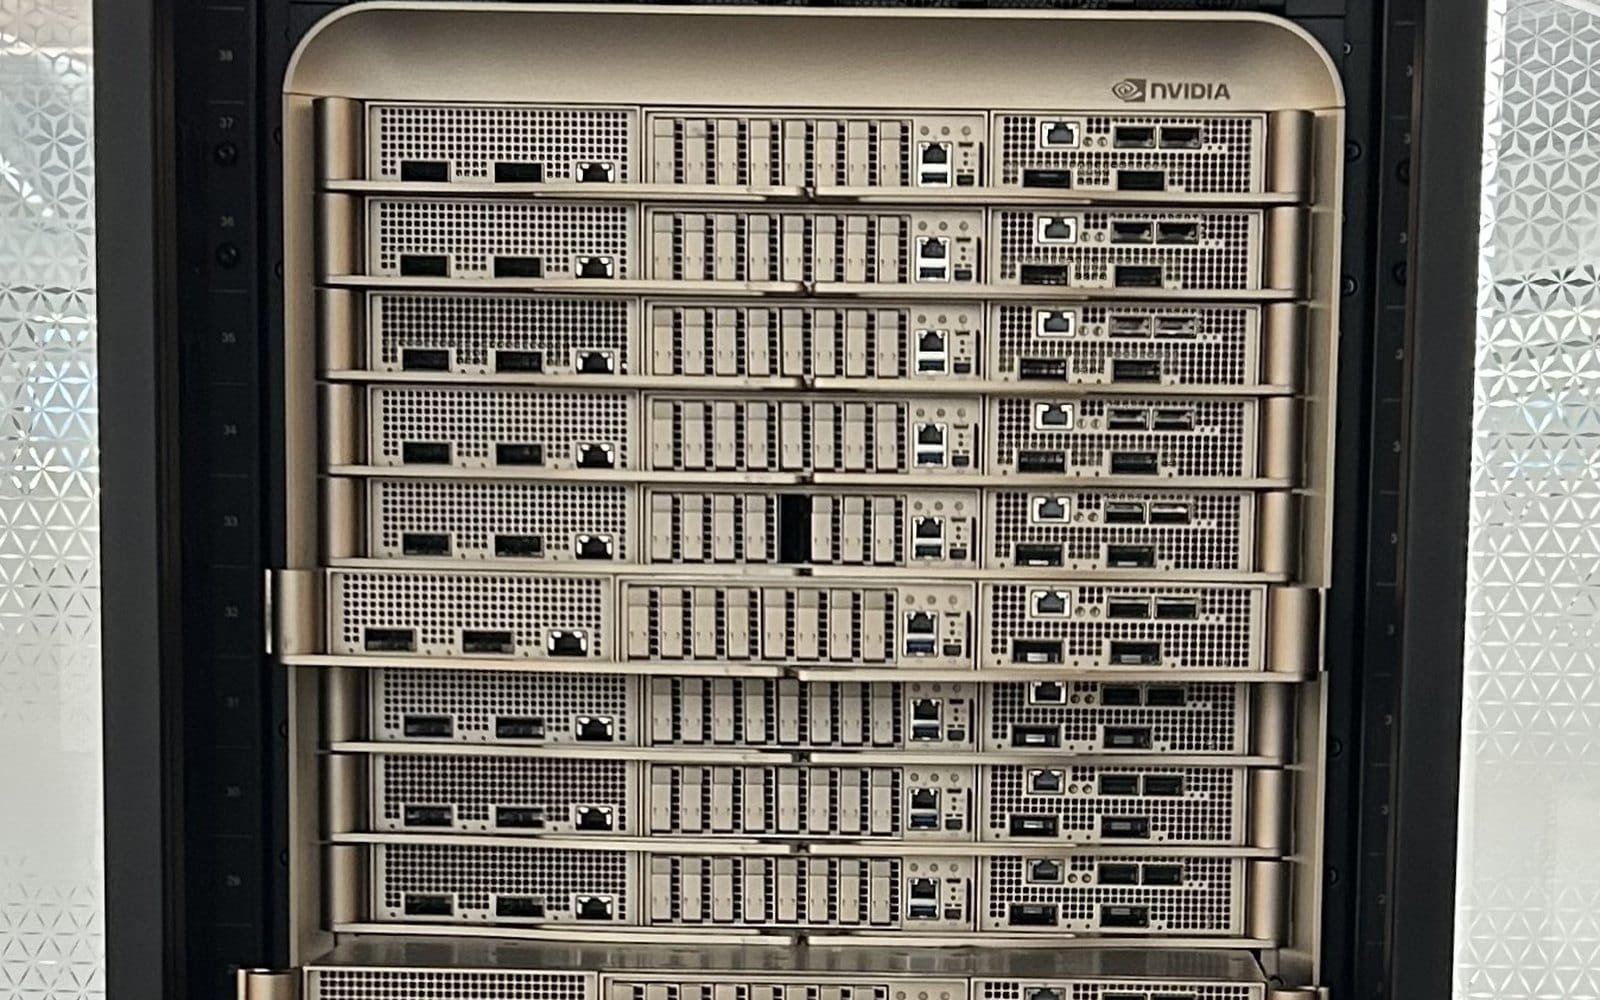
A nova geração de chips de inteligência artificial da Nvidia, a Vera Rubin, fez sua estreia nesta segunda-feira (16) no MLPerf Training, o teste de referência mais usado pela indústria para medir quanto tempo um sistema leva para treinar modelos de IA. Segundo a empresa, o rack Vera Rubin NVL72 foi o mais rápido em seis dos sete testes da rodada e entregou até o dobro do desempenho por GPU em relação ao GB300 NVL72, a geração Blackwell Ultra que hoje equipa os maiores data centers do mundo.
A rodada, chamada MLPerf Training v6.1, foi divulgada pelo MLCommons, consórcio de engenharia que reúne empresas e universidades e organiza os testes, durante a semana da conferência de supercomputação SC26, em Chicago. Também foi a primeira aparição da TPU de sétima geração do Google, a Ironwood, que ficou perto da Nvidia na disputa de grande escala.
Recorde de participação e dois testes novos
De acordo com o MLCommons, 24 organizações enviaram 153 sistemas, que produziram 250 resultados. Dos sistemas testados, 57 (37%) rodavam em nuvem, ante 29% na rodada anterior, divulgada seis meses atrás. Doze sistemas usaram mil aceleradores ou mais, e o maior chegou a 10.240 chips. Participaram máquinas com hardware da Nvidia, da AMD e do Google; a empresa de nuvem Crusoe enviou resultados pela primeira vez.
A versão 6.1 trouxe dois testes inéditos. Um deles é um sistema de recomendação, o DLRMv4-HSTU, do tipo usado para sugerir conteúdos e produtos. O outro, mais simbólico, mede o pós-treinamento do modelo Qwen3.5-397B com aprendizado por reforço: o sistema aprende a resolver tarefas de engenharia de software e a usar ferramentas, uma etapa central dos atuais agentes de IA. Segundo o consórcio, é a primeira vez que o MLPerf testa esse tipo de carga de trabalho.
Vera Rubin dobra o ritmo em parte dos testes
O ganho mais expressivo apareceu no treinamento do DeepSeek-V3, modelo de 671 bilhões de parâmetros. Com 1.024 GPUs distribuídas em 16 racks, o Vera Rubin NVL72 atingiu a qualidade exigida em 4,14 minutos, contra 8,03 minutos do GB300 NVL72 com o mesmo número de chips, segundo a Nvidia. Ao passar de 256 para 1.024 GPUs, o tempo caiu de 16,12 para 4,14 minutos, o que a empresa calcula como cerca de 97% de eficiência de escala.
Nos demais testes, a vantagem por GPU sobre o GB300 ficou entre 1,4 e 1,6 vez, pelos números da fabricante. No novo teste de aprendizado por reforço, a Vera Rubin levou 10,44 minutos com 1.024 GPUs, ante 13,78 minutos da geração anterior.
A geração atual ainda detém o resultado absoluto mais rápido da rodada no DeepSeek-V3: um supercomputador da própria Nvidia com 10.240 chips GB300 concluiu o teste em 1,38 minuto. A Microsoft, com o Azure, chegou à mesma escala usando chips GB200. A CoreWeave foi a única empresa de nuvem a enviar resultados da Vera Rubin nesse teste, com 17,65 minutos em 256 GPUs, 2,7 vezes mais rápido que o seu próprio sistema GB200 de mesmo tamanho, segundo a empresa.
Google encosta em grande escala; AMD fica de fora dos maiores testes
Com 8.192 TPUs Ironwood, o Google concluiu o DeepSeek-V3 em 1,70 minuto. Em análise dos dados da rodada, o site alemão Hardwareluxx comparou o resultado com o de um sistema GB300 de mesmo tamanho, que levou 1,53 minuto, cerca de 10% menos. Segundo o Google, a eficiência de escala foi de 96% até 4.096 chips e caiu para 77% ao dobrar para 8.192. No teste de aprendizado por reforço, 640 TPUs levaram 18,02 minutos.
A AMD não enviou resultados para o DeepSeek-V3 nem para o novo teste de aprendizado por reforço, o que impede a comparação direta nas cargas mais pesadas. A maior configuração com chips da empresa, montada pela Crusoe, usou 128 aceleradores Instinct MI355X. Em um dos poucos testes com comparação limpa entre as três famílias, o ajuste fino do Llama 2 70B com oito aceleradores, o levantamento do Hardwareluxx aponta 2,76 minutos para a Vera Rubin, 5,62 para o GB300 e 6,98 para o MI355X.
O que os números medem e o que não medem
O MLPerf Training cronometra quanto tempo cada sistema leva para atingir uma meta de qualidade em tarefas padronizadas, e não o treinamento completo de um modelo comercial. No caso do DeepSeek-V3, por exemplo, a medição parte de um ponto de controle de referência definido pelo consórcio. Os resultados são enviados pelas próprias empresas e revisados pelos participantes, e nem todas rodam todos os testes. Como lembra o Hardwareluxx, o desenho dos servidores, a rede e as versões de software pesam tanto quanto o chip, e as diferenças não devem ser lidas como uma disputa isolada entre processadores. O próprio software também melhora de uma rodada para outra: a AMD, por exemplo, diz ter obtido ganhos com o mesmo hardware em relação à rodada anterior.
Na mesma divulgação, a Nvidia citou resultados do MLPerf Endpoints, um teste de inferência voltado a agentes, mas parte deles, incluindo o da Vera Rubin, ainda é provisória e depende de verificação do MLCommons.
O acesso a esses equipamentos também se tornou tema regulatório. O governo dos Estados Unidos anunciou nesta segunda-feira uma regra provisória que, quando entrar em vigor com a publicação oficial, passará a exigir licença para exportar chips avançados de IA a cinco países, entre eles o Brasil.
Leia também
- EUA passam a exigir licença para enviar chips avançados de IA ao Brasil e travam acesso remoto de empresas chinesas
- Google lança dois novos TPUs para IA: um protege dados sensíveis e outro dobra memória para contextos longos
- Ex-pesquisador da OpenAI diz ter achado nos modelos de IA da DeepSeek e de outras chinesas a marca de chips da Nvidia vetados para a China